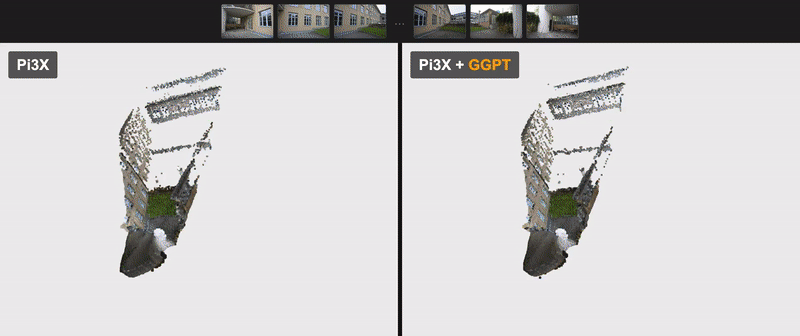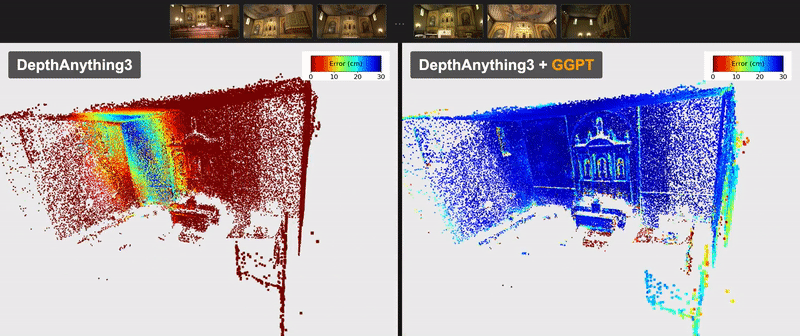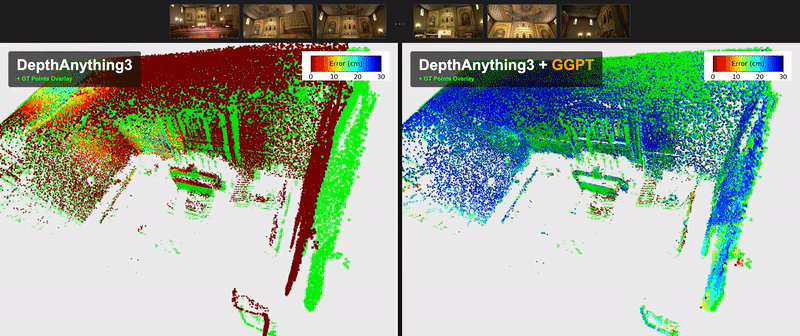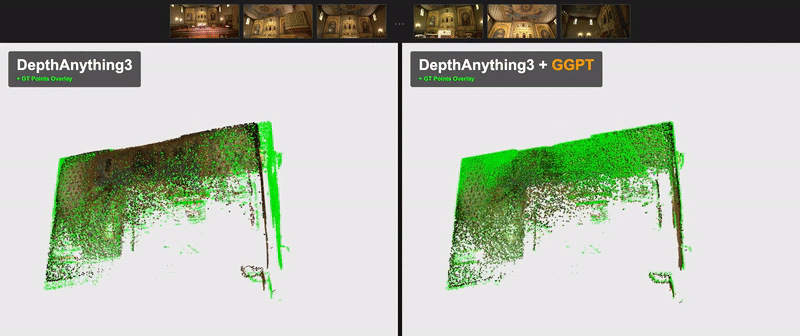
GGPT: Geometry-Grounded Point Transformer
, Yiming Wang, Xucong Zhang, Sergey Prokudin, and Siyu Tang.
CVPR 2026.
Project page | arXiv | Code
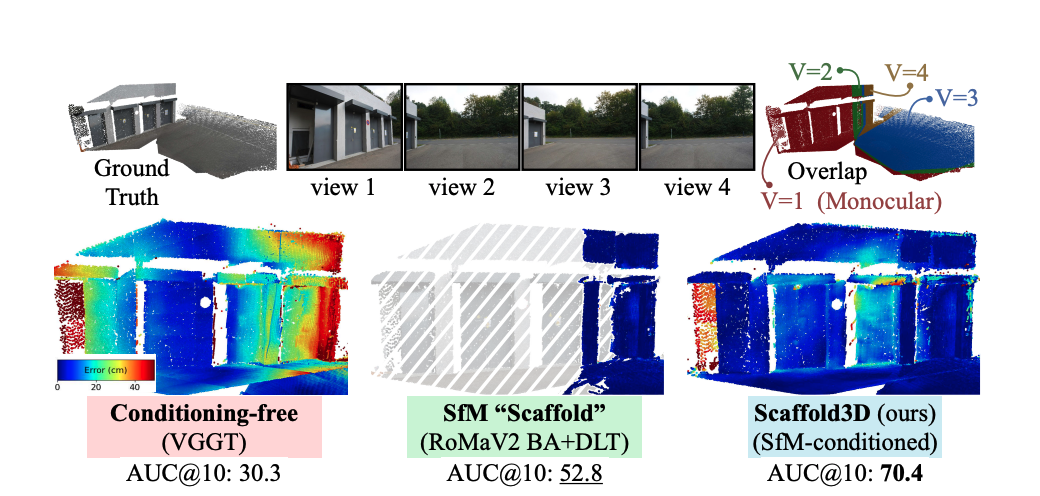
Scaffold3D: SfM-Conditioned Pointmap Prediction for Multi-view 3D Reconstruction
Frano Rajic, , Haofei Xu, Zador Pataki, Marc Pollefeys, and Siyu Tang.
NeurIPS 2026.
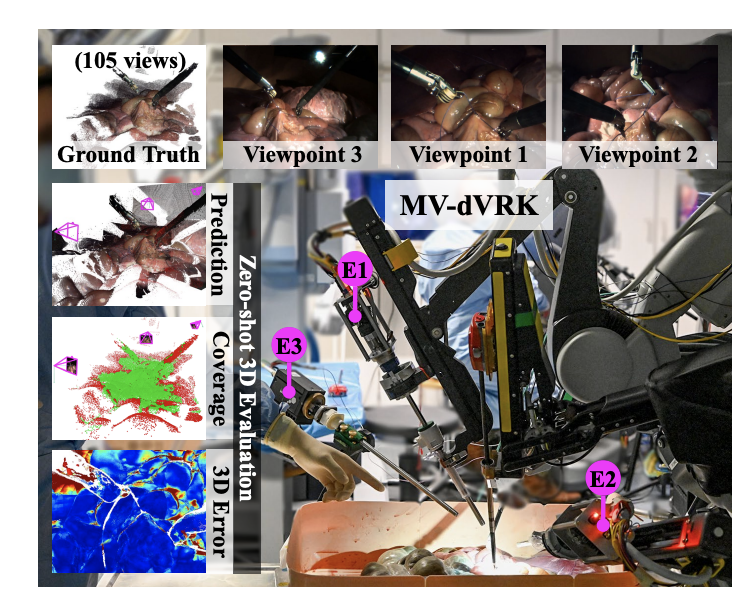
MV-dVRK: A Multi-Viewpoint Benchmark for Spatial Surgical Perception
Guido Caccianiga, Sergey Prokudin, , Bernard Javot, Rachael L'Orsa, Omer Burak Aladag, Yarden Sharon, Jens Rolinger, Ivan Capobianco, Anton Deguet, Siyu Tang, and Katherine J. Kuchenbecker.
Arxiv 2026.

SplatFormer: Point Transformer for Robust 3D Gaussian Splatting
, Yiming Wang, Xucong Zhang, Sergey Prokudin, and Siyu Tang.
ICLR 2025 Spotlight.
Project page | arXiv | Code
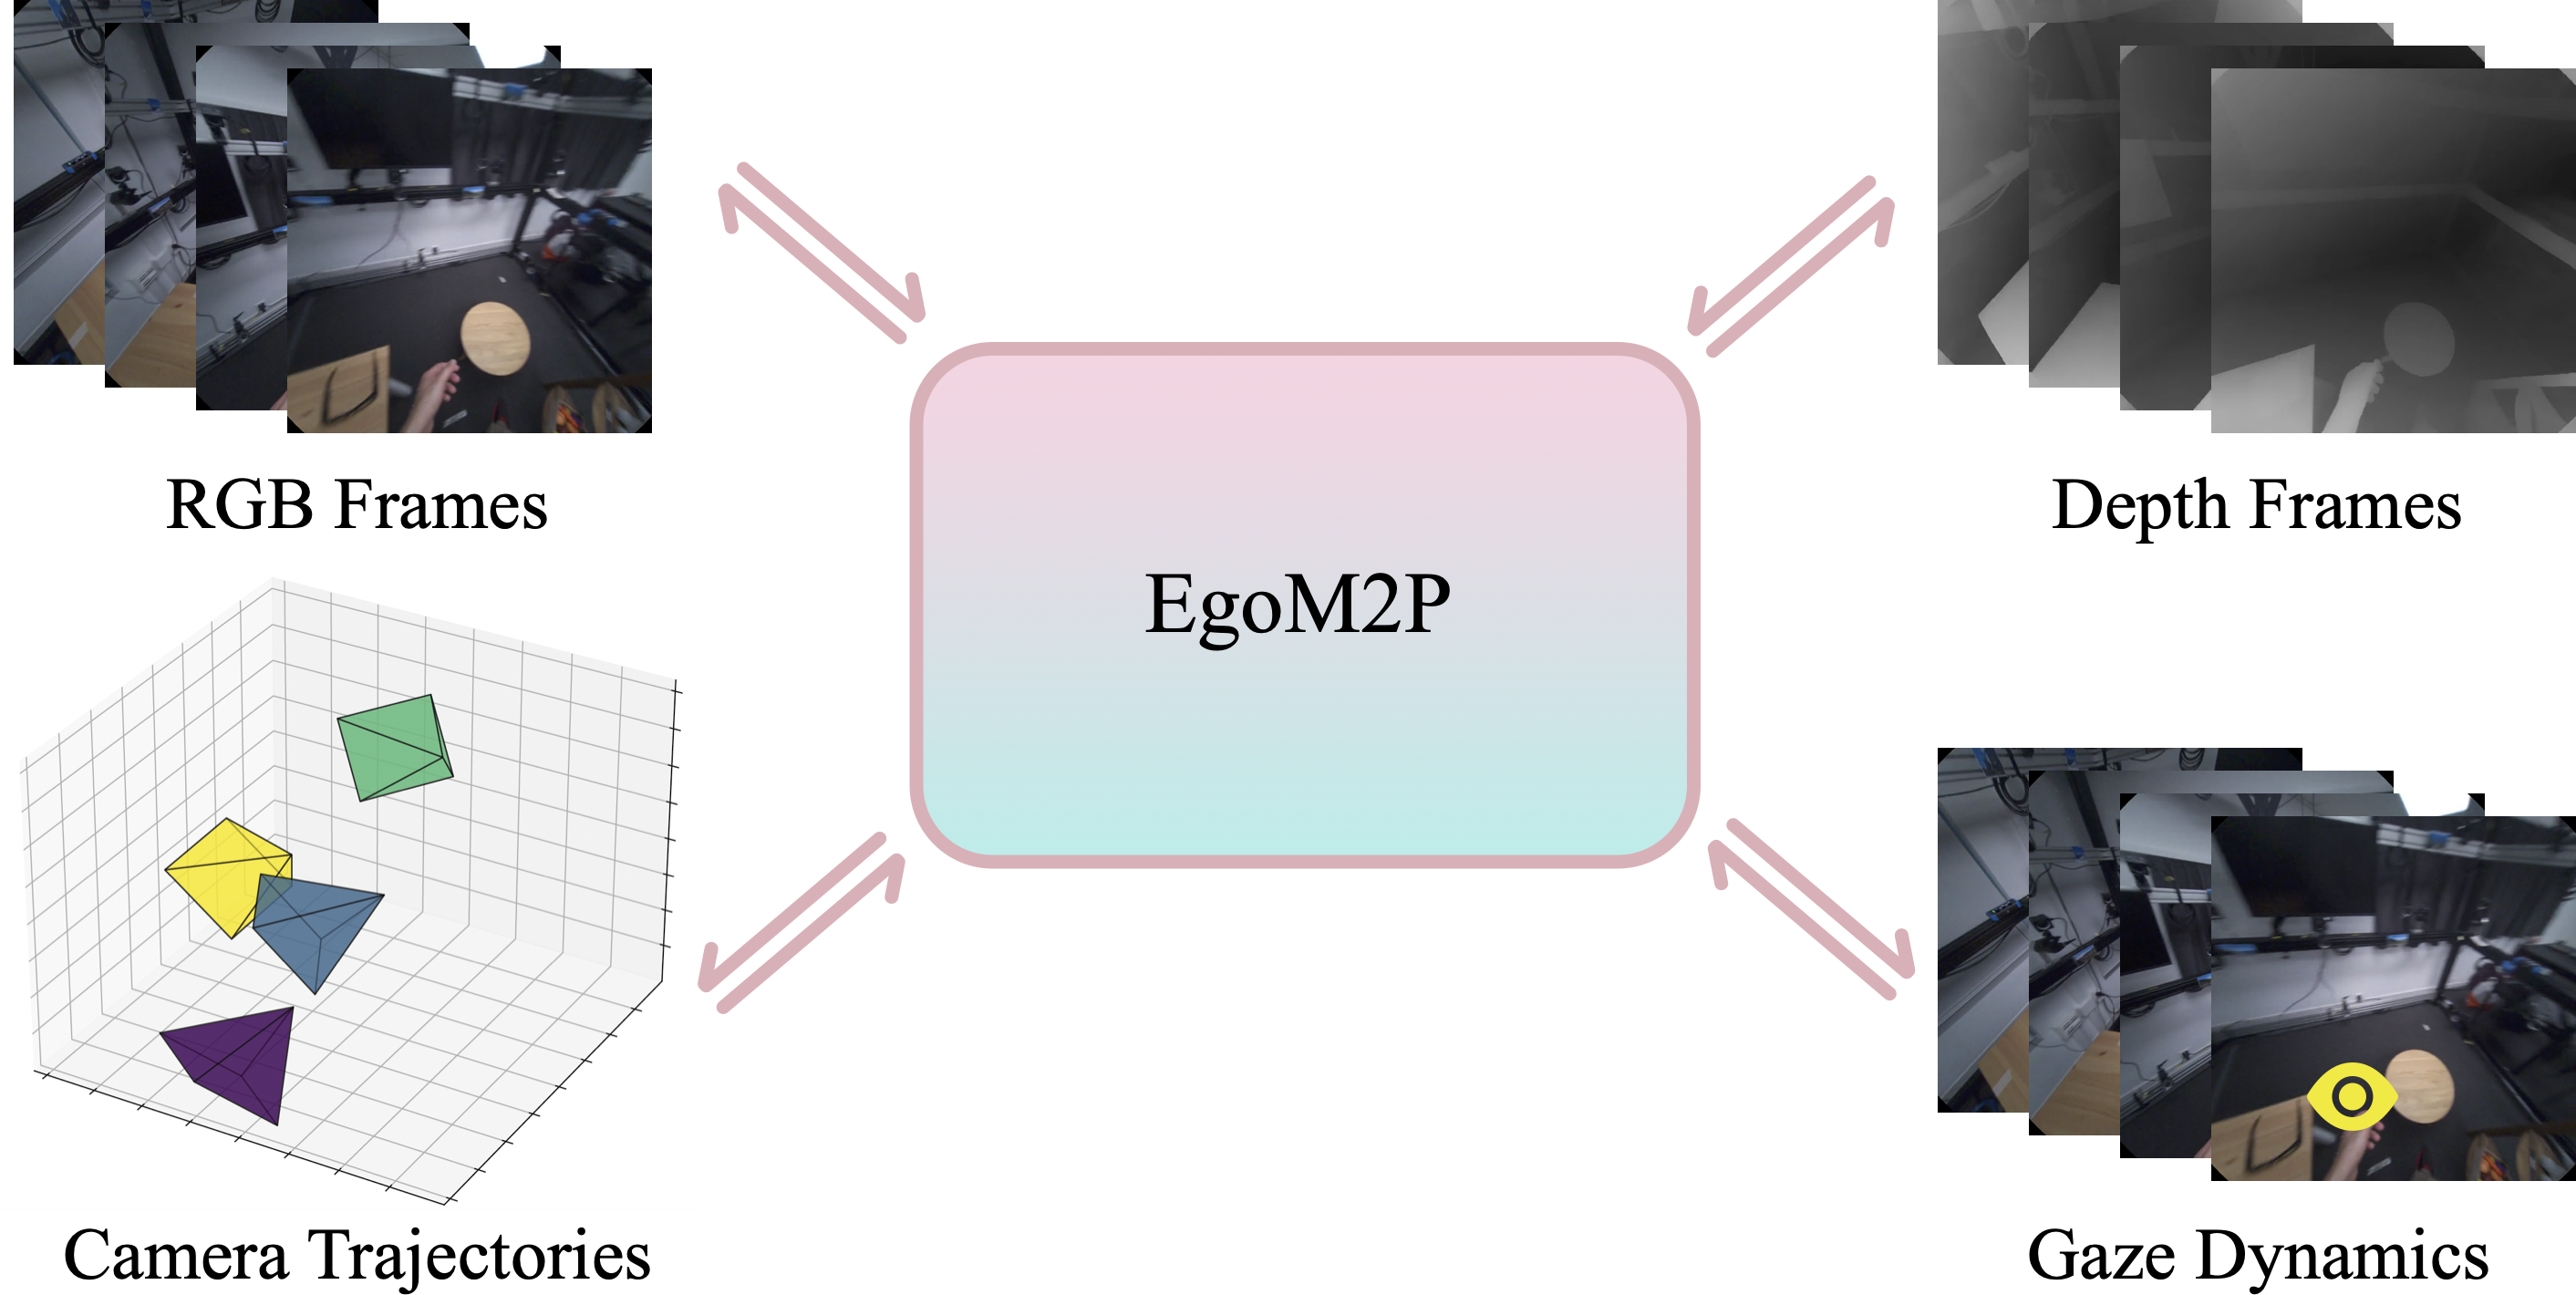
EgoM2P: Egocentric Multimodal Multitask Pretraining
Gen Li, , Yiqian Wu, Kaifeng Zhao, Marc Pollefeys, and Siyu Tang.
ICCV 2025.
Project page | arXiv | Code

Within the Dynamic Context: Inertia-aware 3D Human Modeling with Pose Sequence
*, Yifan Zhan*, Zhihang Zhong, Wei Wang, Xiao Sun, Yu Qiao, Yinqiang Zheng (* indicates equal contribution)
ECCV 2024.
Project page | arXiv | Code

Improving continuous sign language recognition with cross-lingual signs
Fangyun Wei,
ICCV 2023.


